SYSTEM SPECIFICATION & VISION

KUNST AI DOCENT SYSTEM.

보고, 선택하고, 질문하는
혼합현실 AI 도슨트

  1. 01SEE
  2. 02SELECT
  3. 03ASK

THE
VISION.

전문 도슨트는 시간·장소·인원에 묶여 있고, 오디오 가이드는 정해진 설명을 일방적으로 재생할 뿐이라, 관람객은 작품에서 눈을 떼야 하고 떠오른 궁금증은 답을 얻지 못한 채 남습니다.

KUNST는 스마트폰도 안내문도 없이,
작품에서 눈을 떼지 않고 보고·고르고·질문하는 감상을 AI로 구현합니다.

01SEE

보는 순간 인식

YOLOE가 작품 후보를 찾고 DINOv2 임베딩과 ALIKED·LightGlue 매칭으로 작품을 식별·재검증하며, SAM 2.1이 윤곽을 픽셀 단위로 분할해 작품 위에 AR 레이어를 겹칩니다.
YOLOE DINOv2 ALIKED LightGlue SAM 2.1
02SELECT

손끝으로 선택

YOLOv10n·MediaPipe가 손 관절을 추적해 컨트롤러 없이 핀치 한 번으로 작품을 고르고, 손이 작품을 가려도 이전 프레임으로 윤곽을 복원해 AR이 흔들리지 않습니다.
YOLOv10n MediaPipe OneEuro
03ASK

묻는 즉시 답변

온디바이스 sherpa-onnx가 질문을 인식하고, Gemini가 작품 DB와 Google 검색 근거로 답해 Supertonic 음성과 자막으로 함께 전합니다. 해설·추천 질문은 등록 시 1회만 생성해 비용을 줄였고, 모든 추론을 독립 프로세스로 분리해 글라스는 촬영·표시만, 연산은 엣지 서버가 맡는 AR 글라스 구조로 확장됩니다.
sherpa-onnx Gemini API Supertonic 3

CORE ALGORITHMS

KUNST 시스템의 두뇌 역할을 하는 오픈소스 및 상용 AI 모델 파이프라인 명세서입니다.

VISION ENGINE
YOLOE-26s
Object Detection
카메라 시야 내에서 예술품 후보군의 Bounding Box를 0.01초(초저지연) 내에 감지합니다. 전체 컴퓨팅 파이프라인의 연산 병목을 막는 핵심 전처리 모델입니다.
VISION ENGINE
Meta
DINOv2 + ALIKED
Meta Fundamental AI Research (FAIR)
Self-supervised 기반의 비전 트랜스포머(DINOv2)와 ALIKED, LightGlue를 파이프라인으로 결합하여 이미지의 픽셀 특징점을 정밀하게 추출하고 DB와 초정밀 매칭을 수행합니다.
VISION ENGINE
Meta
SAM 2.1
Segment Anything Model 2 (Meta)
식별된 작품의 픽셀 단위 실시간 정밀 실루엣 마스킹을 수행합니다. 비정형 조각상이나 설치 미술의 윤곽선을 완벽하게 추출하여 AR 하이라이트 UI의 렌더링 폴리곤 데이터를 제공합니다.
INTERACTION
Google
YOLOv10n-hands
Ultralytics / Google MediaPipe
관람객의 손 위치를 빠르게 찾고 21개의 손가락 관절을 추적합니다. 엄지와 검지를 맞부딪히는 '핀치' 동작을 인식하여 허공의 AR 인터페이스를 제어합니다.
AUDIO PIPELINE
ONNX
sherpa-onnx
Next-gen Kaldi / ONNX Runtime
온디바이스 환경에서 웨이크워드를 감지하고, 관람객의 이어지는 음성 질문을 실시간으로 텍스트로 변환(Streaming STT)합니다.
LLM DOCENT
Google Gemini
Google Gemini API
Google DeepMind
질문 의도를 파악하고 전문 큐레이터 수준의 통찰력 있는 해설을 즉석에서 생성합니다. 다음 예상 질문까지 추론하여 제안합니다.
AUDIO PIPELINE
Supertonic 3
Speech Synthesis (TTS)
Gemini가 생성한 텍스트 해설을 실시간으로 지연 없이 인간의 억양과 감정이 담긴 자연스러운 음성으로 합성합니다.
DATABASE
Meta
FAISS Indexing
Facebook AI Similarity Search
작품의 특징점 임베딩 벡터를 통해 고속 유사도 검색을 수행, 현재 비추는 작품을 즉각 매칭하는 로컬 DB입니다.
DEEP DIVE

01

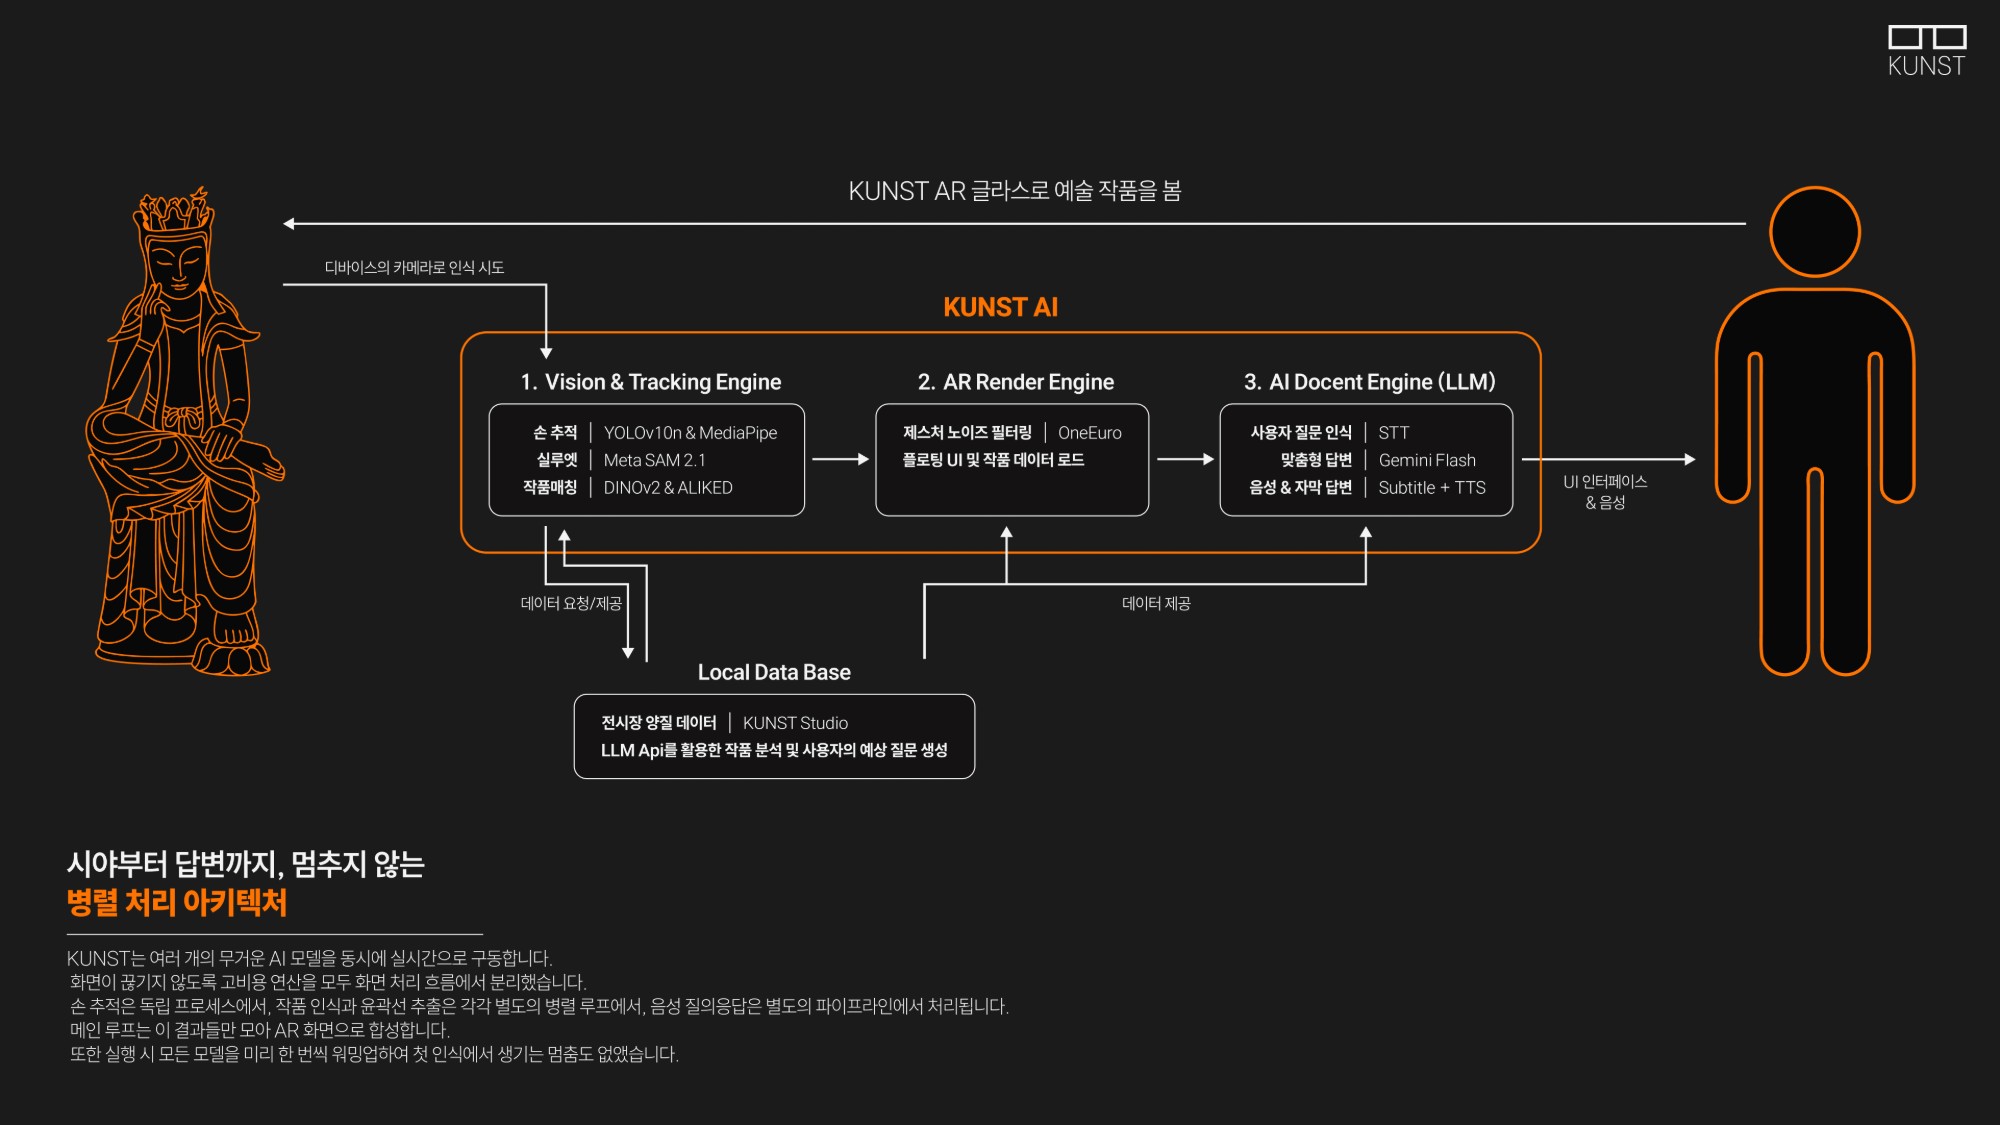
시야부터 답변까지, 멈추지 않는 병렬 처리 아키텍처

KUNST는 여러 개의 무거운 AI 모델을 동시에 실시간으로 구동합니다. 화면이 끊기지 않도록 고비용 연산을 모두 화면 처리 흐름에서 분리했습니다.

손 추적은 독립 프로세스에서, 작품 인식과 윤곽선 추출은 각각 별도의 병렬 루프에서, 음성 질의응답은 별도의 파이프라인에서 처리됩니다. 메인 루프는 이 결과들만 모아 AR 화면으로 합성합니다. 또한 실행 시 모든 모델을 미리 한 번씩 워밍업하여 첫 인식에서 생기는 멈춤도 없앴습니다.

KUNST 시스템 아키텍처 다이어그램
KUNST AI 시스템 아키텍처
1. Vision & Tracking Engine
손 추적 YOLOv10n & MediaPipe
실루엣 Meta SAM 2.1
작품매칭 DINOv2 & ALIKED
2. AR Render Engine
제스처 노이즈 필터링 OneEuro
플로팅 UI 및 작품 데이터 로드
3. AI Docent Engine (LLM)
사용자 질문 인식 STT
맞춤형 답변 Gemini Flash
음성 & 자막 답변 Subtitle + TTS
Local Data Base
전시장 양질 데이터 KUNST Studio
LLM API를 활용한 작품 분석 및 사용자의 예상 질문 생성
02

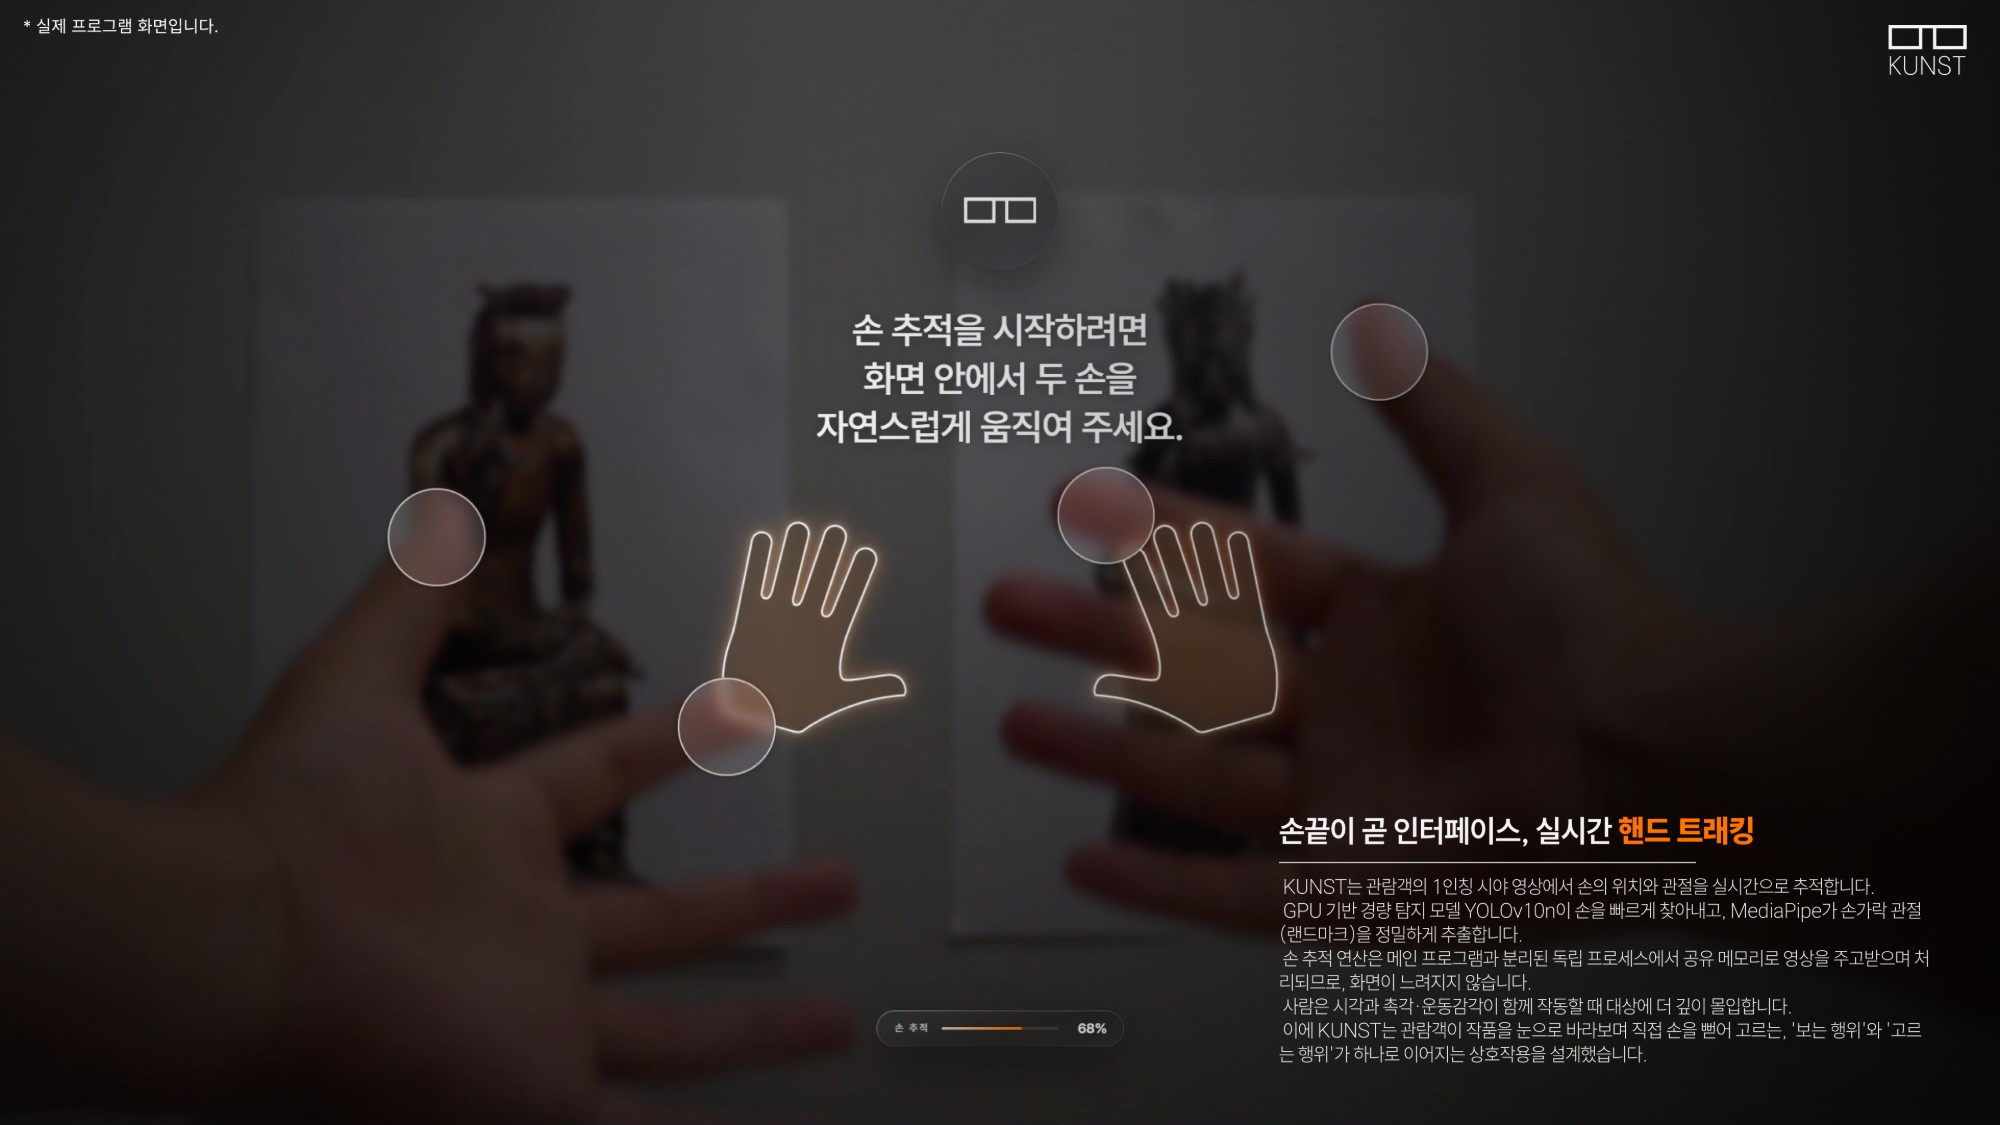
손끝이 곧 인터페이스, 실시간 핸드 트래킹

KUNST는 관람객의 1인칭 시야 영상에서 손의 위치와 관절을 실시간으로 추적합니다. GPU 기반 경량 탐지 모델 YOLOv10n이 손을 빠르게 찾아내고, MediaPipe가 손가락 관절(랜드마크)을 정밀하게 추출합니다.

손 추적 연산은 메인 프로그램과 분리된 독립 프로세스에서 공유 메모리로 영상을 주고받으며 처리되므로, 화면이 느려지지 않습니다. 사람은 시각과 촉각, 운동감각이 함께 작동할 때 대상에 더 깊이 몰입합니다. 이에 KUNST는 관람객이 작품을 눈으로 바라보며 직접 손을 뻗어 고르는, '보는 행위'와 '고르는 행위'가 하나로 이어지는 상호작용을 설계했습니다.

두 손의 관절을 실시간으로 추적하는 KUNST 실행 화면
실제 프로그램 화면입니다.
03

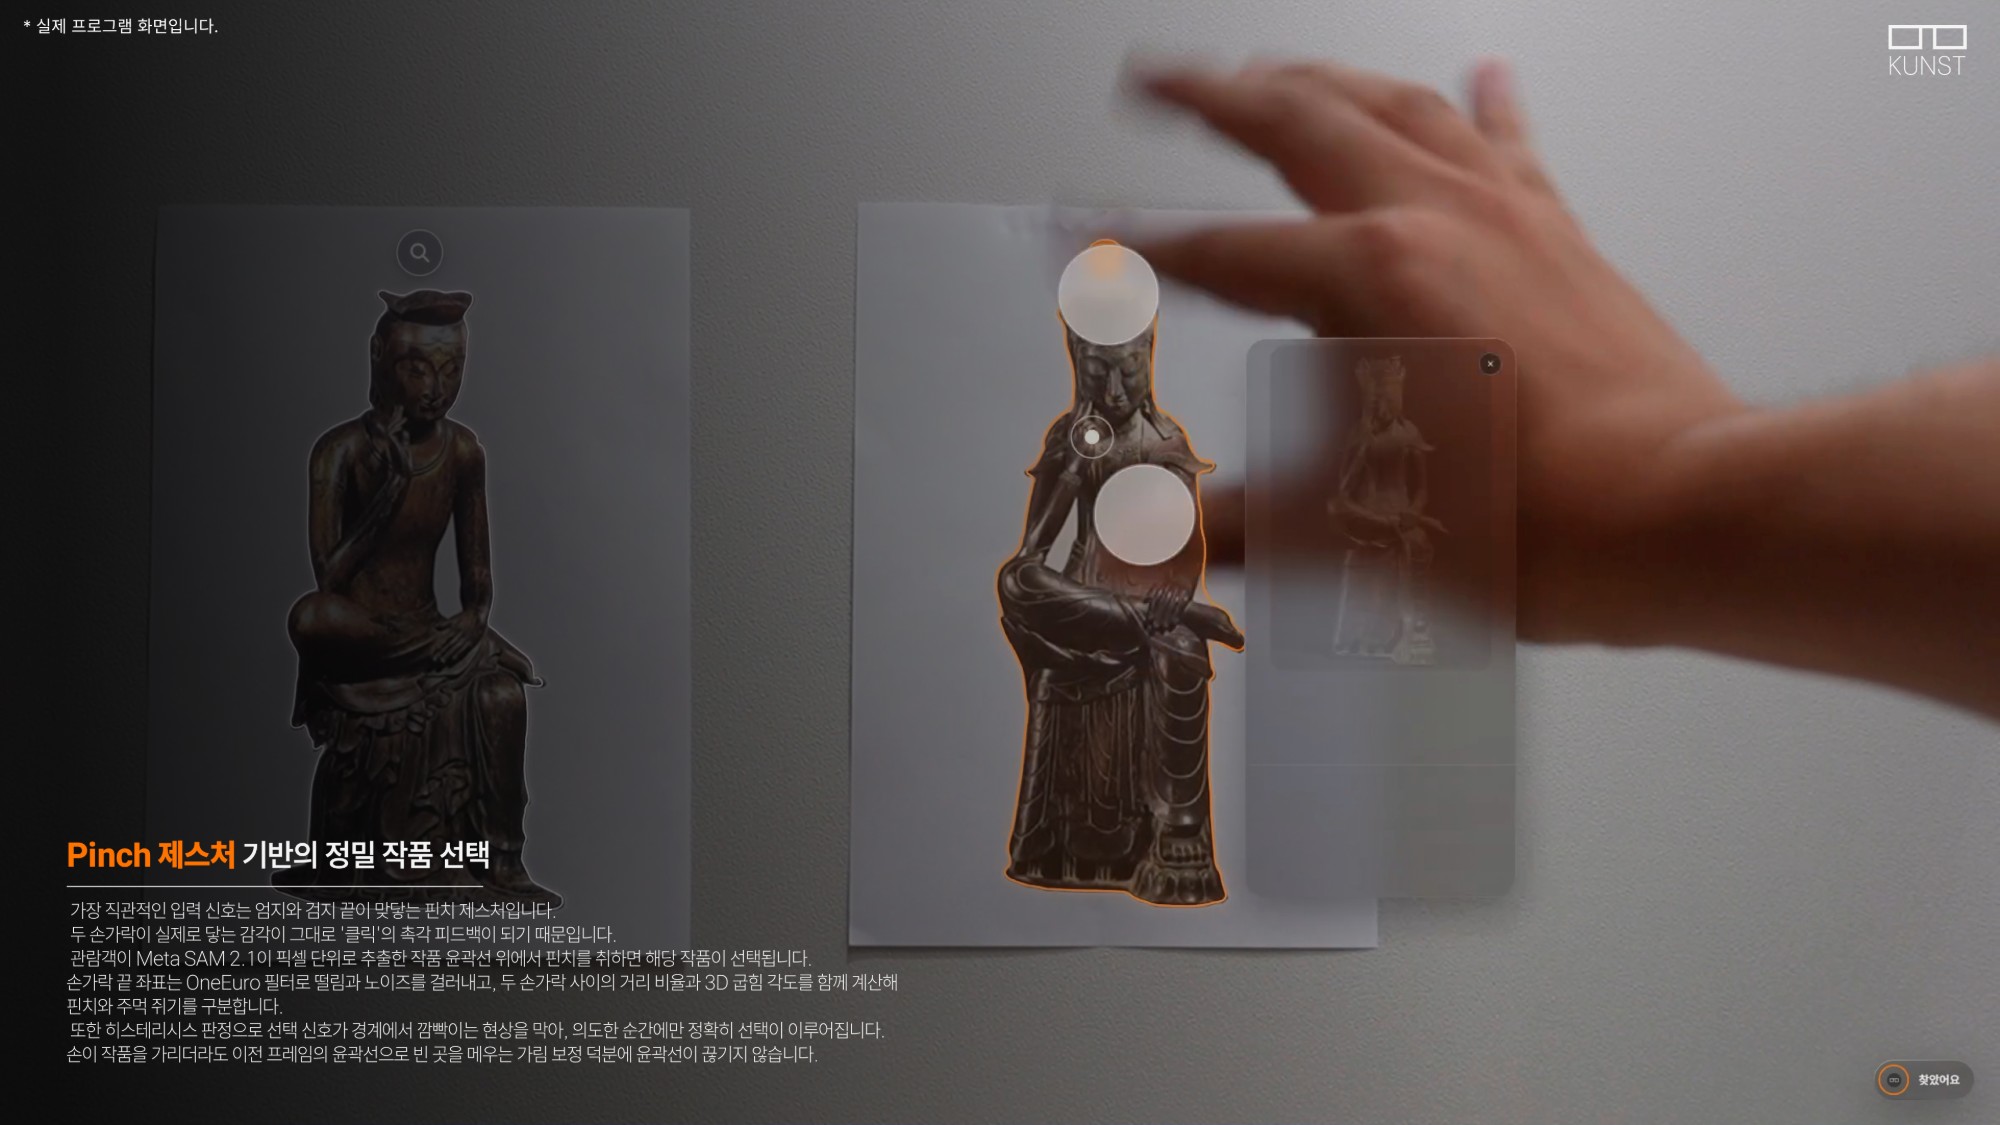
Pinch 제스처 기반의 정밀 작품 선택

가장 직관적인 입력 신호는 엄지와 검지 끝이 맞닿는 핀치 제스처입니다. 두 손가락이 실제로 닿는 감각이 그대로 '클릭'의 촉각 피드백이 되기 때문입니다.

관람객이 Meta SAM 2.1이 픽셀 단위로 추출한 작품 윤곽선 위에서 핀치를 취하면 해당 작품이 선택됩니다. 손가락 끝 좌표는 OneEuro 필터로 떨림과 노이즈를 걸러내고, 두 손가락 사이의 거리 비율과 3D 굽힘 각도를 함께 계산해 핀치와 주먹 쥐기를 구분합니다.

또한 히스테리시스 특성으로 선택 신호가 경계에서 깜빡이는 현상을 막아 의도한 순간에만 정확히 선택이 이루어집니다. 손이 작품을 가리더라도 이전 프레임의 윤곽선으로 빈 곳을 메우는 가림 보정 덕분에 윤곽선이 끊기지 않습니다.

작품 윤곽선 위에서 핀치 제스처로 작품을 선택하는 화면
실제 프로그램 화면입니다.
04

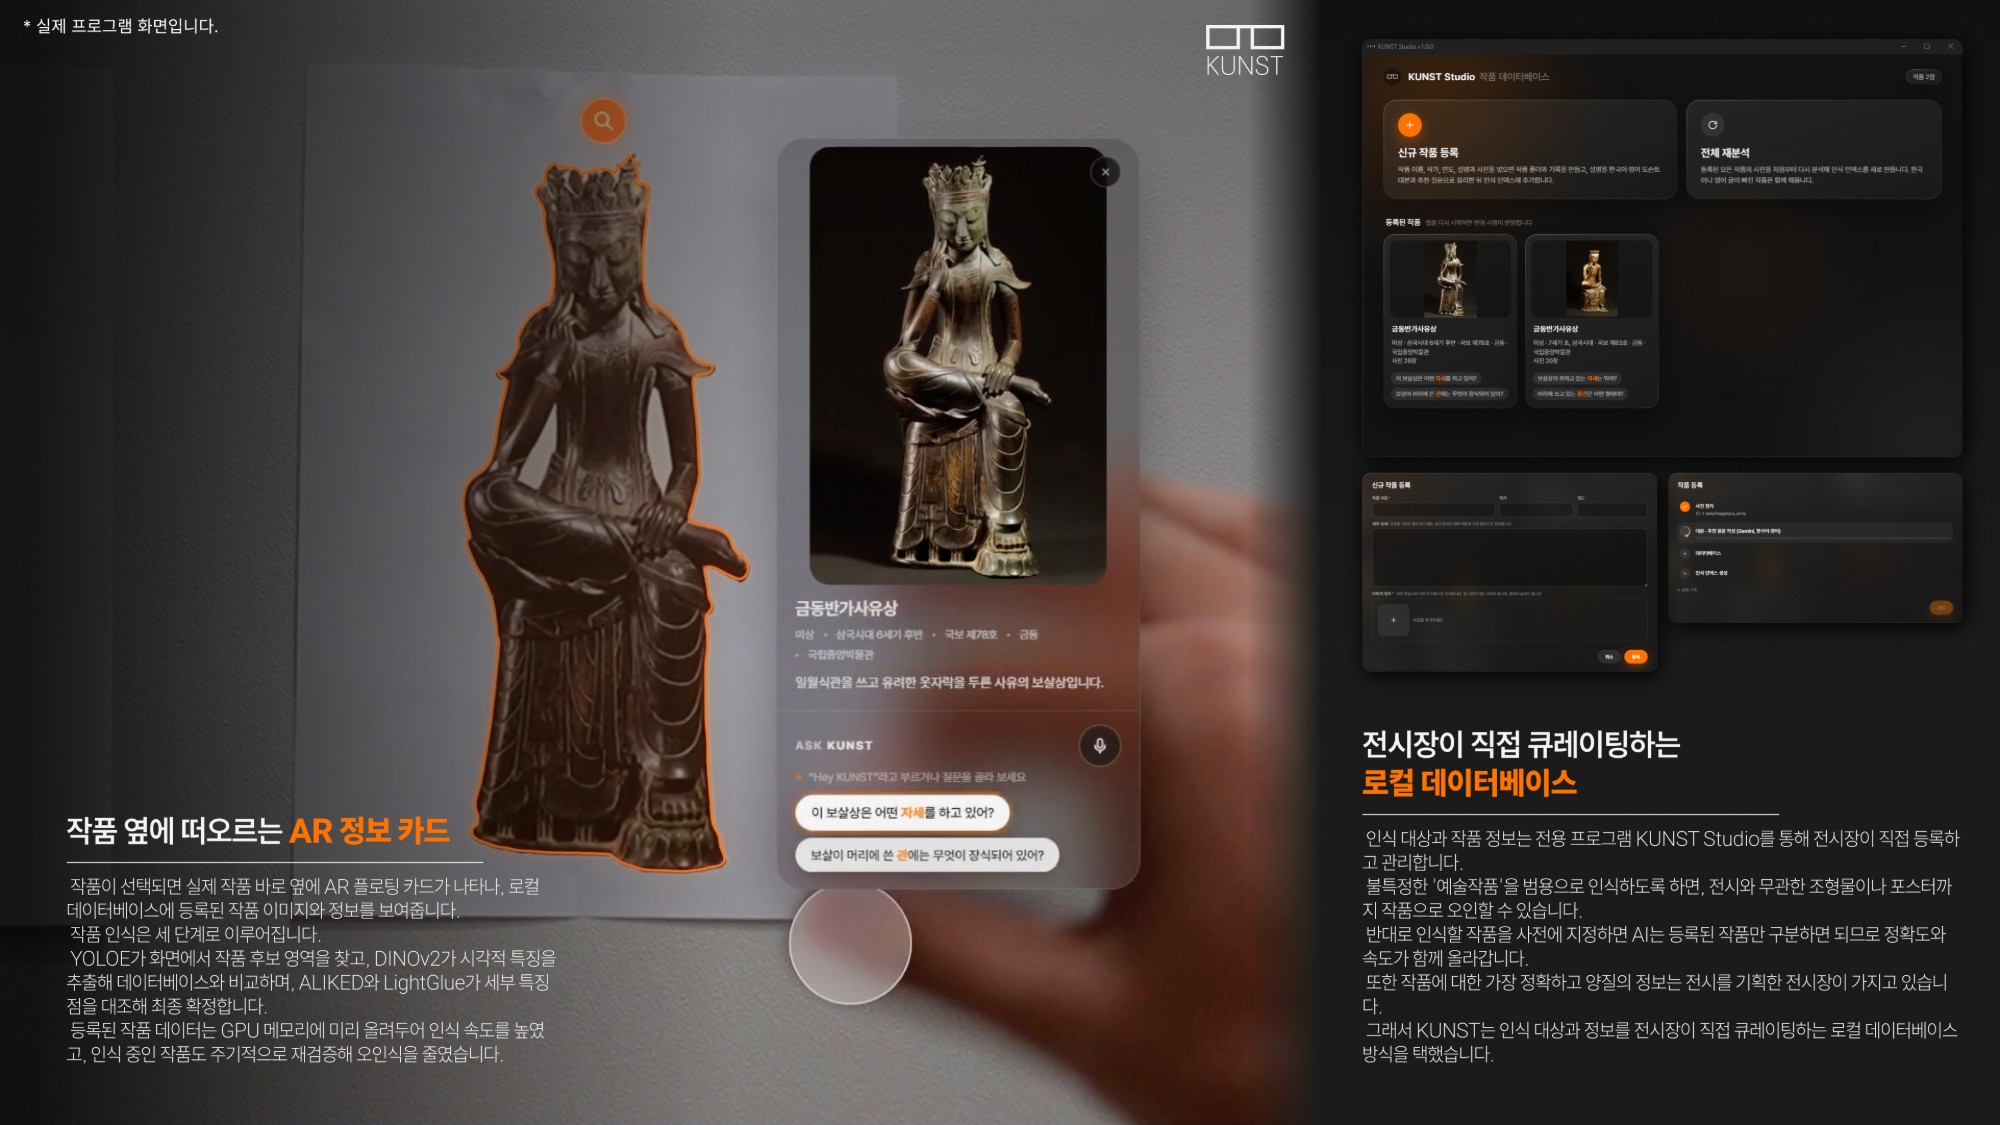
작품 옆에 떠오르는 AR 정보 카드 & 로컬 데이터베이스

작품이 선택되면 실제 작품 바로 옆에 AR 플로팅 카드가 나타나, 로컬 데이터베이스에 등록된 작품 이미지와 정보를 보여줍니다. 작품 인식은 세 단계로 이루어집니다. YOLOE가 화면에서 작품 후보 영역을 찾고, DINOv2가 시각적 특징을 추출해 데이터베이스와 비교하며, ALIKED와 LightGlue가 세부 특징점을 대조해 최종 확정합니다. 등록된 작품 데이터는 GPU 메모리에 미리 올려두어 인식 속도를 높였고, 인식 중인 작품도 주기적으로 재검증해 오인식을 줄였습니다.

인식 대상과 작품 정보는 전용 프로그램 KUNST Studio를 통해 전시장이 직접 등록하고 관리합니다. 불특정한 '예술작품'을 범용으로 인식하도록 하면, 전시와 무관한 조형물이나 포스터까지 작품으로 오인할 수 있습니다. 반대로 인식할 작품을 사전에 지정하면 AI는 등록된 작품만 구분하면 되므로 정확도와 속도가 함께 올라갑니다. 또한 작품에 대한 가장 정확하고 양질의 정보는 전시를 기획한 전시장이 가지고 있습니다. 그래서 KUNST는 인식 대상과 정보를 전시장이 직접 큐레이팅하는 로컬 데이터베이스 방식을 택했습니다.

KUNST Studio에서 작품 이름과 작가, 연도, 설명문과 사진을 넣고 신규 작품 등록을 누르면, 작품 폴더와 기록이 만들어지고 설명문이 한국어·영어 도슨트 대본과 추천 질문으로 정리된 뒤 인식 인덱스에 추가됩니다. 전체 재분석은 등록된 모든 작품의 사진을 최신 모델로 다시 분석해 인식 인덱스를 새로 만들고, 대본과 추천 질문도 함께 다시 생성합니다. 해설과 추천 질문은 등록 시점에 한 번만 생성되므로 관람 중 반복되는 LLM 호출 비용이 들지 않습니다.

작품 옆에 뜬 AR 정보 카드와 KUNST Studio 작품 데이터베이스 화면
실제 프로그램 화면입니다. (오른쪽: KUNST Studio)
05

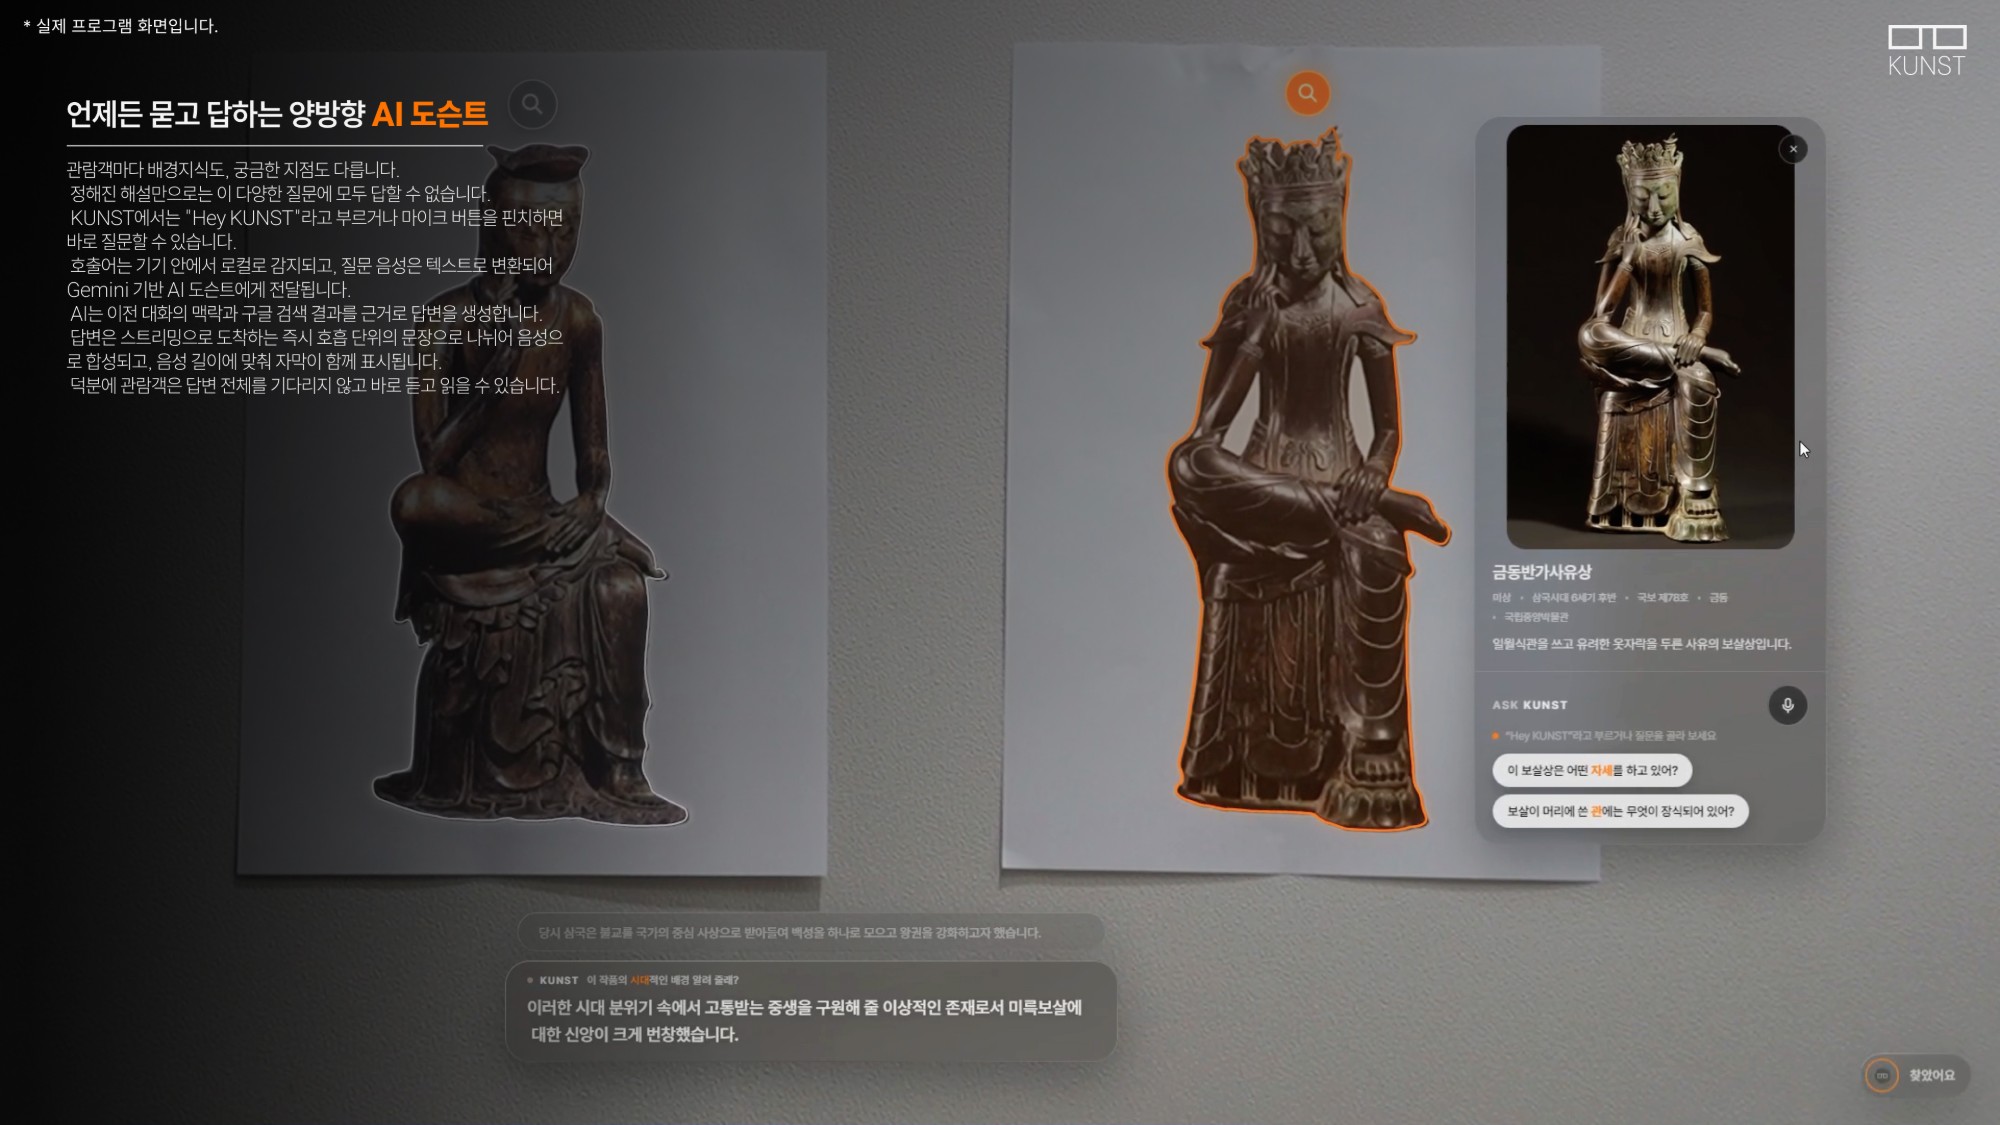
언제든 묻고 답하는 양방향 AI 도슨트

관람객마다 배경지식도, 궁금한 지점도 다릅니다. 정해진 해설만으로는 이 다양한 질문에 모두 답할 수 없습니다. KUNST에서는 "Hey KUNST"라고 부르거나 마이크 버튼을 핀치하면 바로 질문할 수 있습니다.

호출어는 기기 안에서 로컬로 감지되고, 질문 음성은 텍스트로 변환되어 Gemini 기반 AI 도슨트에게 전달됩니다. AI는 이전 대화의 맥락과 구글 검색 결과를 근거로 답변을 생성합니다.

답변은 스트리밍으로 도착하는 즉시 호흡 단위의 문장으로 나뉘어 음성으로 합성되고, 음성 길이에 맞춰 자막이 함께 표시됩니다. 덕분에 관람객은 답변 전체를 기다리지 않고 바로 듣고 읽을 수 있습니다.

질문에 대한 답변이 음성과 자막으로 표시되는 화면
실제 프로그램 화면입니다.

GET KUNST v1.1.2.

데스크톱 실행 파일과 전시장용 관리 도구 KUNST Studio가 함께 제공됩니다.

DOWNLOAD KUNST (WindowsWINDOWS 11)